
XGBoost: guía práctica con Python
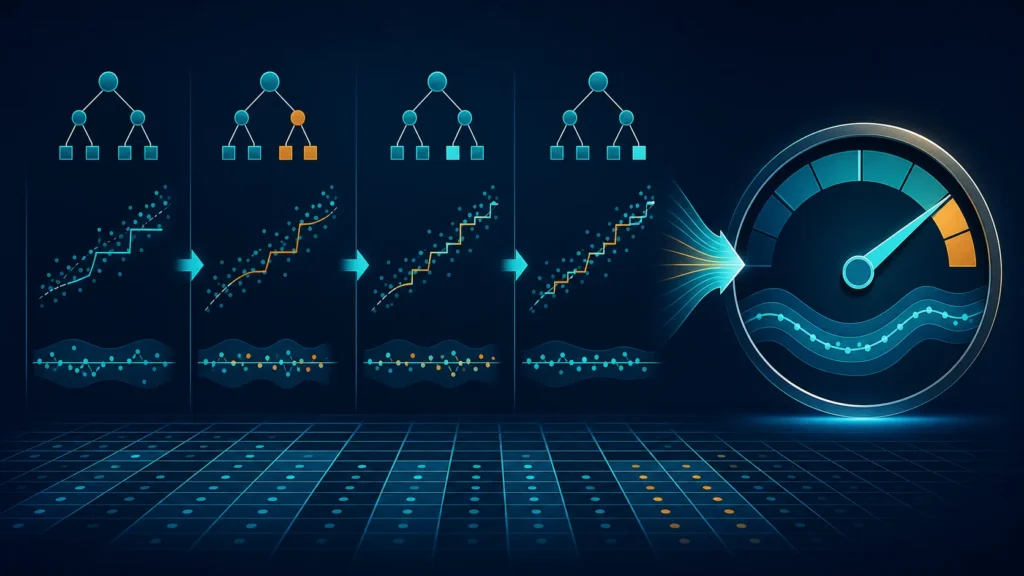
XGBoost es una implementación optimizada de gradient boosting con árboles de decisión. Construye árboles de forma secuencial para corregir los errores del conjunto anterior e incorpora regularización, manejo de valores ausentes y ejecución eficiente. Es una referencia sólida para problemas tabulares de clasificación y regresión.
La idea del boosting
Un árbol individual divide el espacio de variables mediante reglas. En boosting, cada nuevo árbol se entrena para mejorar la predicción agregada. La contribución se escala mediante learning_rate y el número total se controla con n_estimators o rondas de boosting.
Muchos árboles pequeños pueden generalizar mejor que pocos árboles demasiado agresivos. La combinación correcta depende de datos, ruido y validación.
Preparar un ejemplo de clasificación
from xgboost import XGBClassifier
from sklearn.model_selection import train_test_split

X_train, X_valid, y_train, y_valid = train_test_split(
    X,
    y,
    test_size=0.2,
    stratify=y,
    random_state=42,
)

modelo = XGBClassifier(
    n_estimators=800,
    learning_rate=0.05,
    max_depth=5,
    subsample=0.8,
    colsample_bytree=0.8,
    eval_metric="logloss",
    random_state=42,
)
La API y los parámetros pueden cambiar entre versiones. Fija dependencias y consulta la documentación de la instalación usada.
Entrenar sin fuga de datos
Separa validación antes de aprender imputación, escalado o codificación. Encapsula transformaciones en un pipeline y ajústalas solo con entrenamiento. Si hay tiempo, usuarios o grupos, usa una división que respete esa estructura.
XGBoost puede manejar valores ausentes en características numéricas mediante una dirección aprendida, pero aún debes comprender por qué faltan y tratar categorías o texto de forma adecuada.
Parámetros principales
max_depth controla profundidad; min_child_weight exige suficiente peso para crear nodos; gamma requiere una mejora mínima para dividir. subsample toma una fracción de filas y colsample_bytree una fracción de columnas, lo que puede reducir sobreajuste.
reg_alpha aplica regularización L1 y reg_lambda L2. Valores más fuertes simplifican contribuciones, pero no sustituyen una validación correcta.
learning_rate reduce el aporte de cada árbol. Normalmente se compensa con más rondas. No ajustes parámetros uno por uno sobre el conjunto de prueba.
Early stopping
El early stopping detiene el entrenamiento cuando la métrica de validación deja de mejorar durante varias rondas. Ayuda a encontrar una complejidad útil sin fijar de antemano el número exacto de árboles.
La forma de pasar eval_set y configurar early stopping depende de la versión. Después, conserva la mejor iteración y evalúa una sola vez en el conjunto de prueba final.
Clases desbalanceadas
Accuracy puede ocultar una clase minoritaria. Usa precision, recall, F1, curvas precision-recall y costes del negocio. scale_pos_weight puede reponderar clases, pero debes calcularlo en entrenamiento y verificar calibración.
El umbral predeterminado de 0,5 no siempre es adecuado. Selecciónalo con validación según el coste de falsos positivos y negativos.
Variables categóricas
Según versión y configuración, XGBoost ofrece soporte para categorías. Otra opción es one-hot encoding o codificación controlada dentro de un pipeline. Nunca calcules target encoding usando todo el dataset sin validación cruzada: filtraría el objetivo.
Para cardinalidad alta, compara alternativas y mide memoria. Conserva nombres y transformaciones para interpretar el modelo.
Importancia y explicación
La importancia incorporada puede medir ganancia, cobertura o frecuencia, y cada definición responde a una pregunta diferente. Variables correlacionadas se reparten la importancia. SHAP puede explicar contribuciones locales y globales, pero también requiere cuidado con correlaciones y causalidad.
No presentes una importancia como prueba de que una variable causa el resultado. Combina análisis, conocimiento del dominio y pruebas de estabilidad.
Ajuste de hiperparámetros
Empieza con una línea base y presupuesto limitado. Usa validación cruzada coherente con el problema, búsqueda aleatoria o bayesiana y registra resultados. Ajusta profundidad, tasa, submuestreo y regularización en rangos razonables.
Compara contra regresión, Random Forest y un baseline trivial. La mejora debe justificar coste, latencia y complejidad.
Despliegue
Guarda modelo, transformaciones, columnas y versión de biblioteca. Valida el esquema de entrada y no aceptes columnas reordenadas silenciosamente. Mide latencia, deriva, calidad por segmento y calibración.
Planifica rollback y reentrenamiento. Un notebook con buen resultado no es un servicio reproducible: necesita pruebas, control de dependencias y observabilidad.
Continúa aprendiendo
Amplía este tema con nuestras guías sobre precision, recall y F1, validación cruzada, Random Forest.
Fuentes oficiales
Preguntas frecuentes
¿Qué es XGBoost?
Una biblioteca optimizada de gradient boosting que combina árboles secuenciales con regularización y alto rendimiento.
¿Para qué datos funciona bien?
Suele destacar en datos tabulares para clasificación, regresión y ranking, aunque debe compararse con líneas base.
¿Qué hace learning_rate?
Reduce la contribución de cada árbol; valores bajos suelen requerir más rondas de boosting.
¿Para qué sirve early stopping?
Detiene el entrenamiento cuando la métrica de validación deja de mejorar y ayuda a limitar sobreajuste.
¿Cómo trato clases desbalanceadas?
Con métricas adecuadas, ponderación si procede y selección del umbral según costes, todo validado fuera del entrenamiento.
¿La importancia de variables implica causalidad?
No. Describe el uso predictivo bajo una definición concreta y puede distorsionarse por correlaciones.
Deja una respuesta