
Regresión logística: qué es y ejemplo
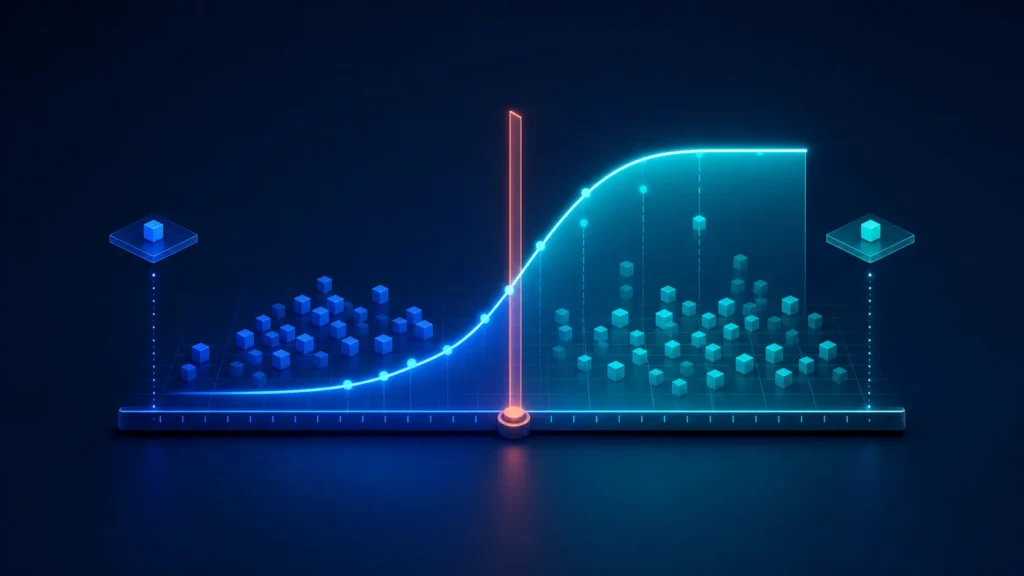
La regresión logística es un modelo de clasificación que estima la probabilidad de una clase. Aunque se llama regresión, en machine learning se utiliza para decisiones como fraude/no fraude, abandono/no abandono o respuesta/no respuesta.
Es una línea base potente: rápida, interpretable y capaz de producir probabilidades si se especifica y evalúa correctamente.
De una combinación lineal a probabilidad
El modelo calcula:
z = β0 + β1x1 + β2x2 + ... + βpxp
Y aplica la función sigmoide:
p = 1 / (1 + e^-z)
El resultado está entre 0 y 1. Un umbral convierte probabilidad en clase, pero 0.5 no es obligatorio.
Log-odds
La regresión logística modela:
log(p / (1 - p)) = β0 + β1x1 + ...
e^β es una razón de odds asociada a un incremento de una unidad, manteniendo las demás variables constantes. No equivale directamente a un aumento fijo en puntos porcentuales; el efecto en probabilidad depende del punto de partida.
Ejemplo en Python
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

preparacion = ColumnTransformer([
    ("num", Pipeline([
        ("imputar", SimpleImputer(strategy="median")),
        ("escalar", StandardScaler()),
    ]), ["antiguedad", "compras_90d"]),
    ("cat", Pipeline([
        ("imputar", SimpleImputer(strategy="most_frequent")),
        ("onehot", OneHotEncoder(handle_unknown="ignore")),
    ]), ["plan", "region"]),
])

modelo = Pipeline([
    ("preparacion", preparacion),
    ("clasificador", LogisticRegression(max_iter=1000)),
])

modelo.fit(X_train, y_train)
probabilidad = modelo.predict_proba(X_test)[:, 1]
La Pipeline evita ajustar imputación y escalado con el test.
Regularización
La regularización reduce coeficientes para controlar complejidad:
- L2 contrae coeficientes suavemente.
- L1 puede llevar algunos a cero.
- Elastic Net combina ambas según soporte.
En implementaciones comunes como scikit-learn, la regresión logística se regulariza por defecto. La fuerza y compatibilidad dependen de parámetros y solver. Ajusta dentro de validación cruzada, no con el test.
Supuestos prácticos
- Observaciones independientes o dependencia modelada.
- Relación aproximadamente lineal entre variables continuas y log-odds.
- Ausencia de multicolinealidad extrema.
- Muestra suficiente para clases y parámetros.
- Especificación coherente con el tiempo de predicción.
No exige que las variables sean normales.
Umbral de decisión
Si el costo de omitir fraude es alto, puedes bajar el umbral para aumentar recall, aceptando más falsos positivos. Elige umbral con datos de validación y una función de costo.
La matriz de confusión ayuda a contar errores; la curva ROC muestra sensibilidad frente a falsos positivos a distintos umbrales.
Métricas
- Precision: proporción de positivos predichos que son correctos.
- Recall: proporción de positivos reales detectados.
- F1: equilibrio armónico.
- ROC-AUC: ranking global.
- PR-AUC: útil con clase positiva rara.
- Log loss: calidad probabilística.
- Calibración: correspondencia entre 0.7 predicho y frecuencia observada.
Accuracy puede ser 99 % si solo 1 % es positivo y el modelo predice siempre negativo.
Interpretar coeficientes
La escala importa. Un incremento de una unidad puede ser un peso de 1 kg o ingreso de 1 peso. Estandarizar ayuda a comparar magnitudes en ciertos contextos, pero las variables one-hot y las interacciones requieren cuidado.
Reporta intervalos o incertidumbre cuando el objetivo sea inferencia, y diferencia asociación de causalidad.
No linealidad e interacciones
Puedes añadir transformaciones:
- logaritmos;
- splines;
- términos polinómicos;
- interacciones justificadas.
Valida fuera de muestra. Una expansión enorme puede sobreajustar y reducir interpretabilidad.
Clases desbalanceadas
Considera pesos, muestreo, umbral y métricas adecuadas. No balancees antes de dividir: réplicas de una misma observación podrían cruzar conjuntos.
Errores frecuentes
- Interpretar coeficiente como cambio directo de probabilidad.
- Usar 0.5 sin costo.
- Evaluar solo accuracy.
- Ajustar preprocesamiento con todo.
- Ignorar calibración.
- Confundir asociación y causalidad.
- Reportar métricas del entrenamiento.
- Introducir variables posteriores al evento.
Compara esta línea base con modelos más flexibles como árboles de decisión, usando las mismas particiones y criterios.
Preguntas frecuentes
¿La regresión logística es clasificación?
Sí. Modela probabilidades y suele convertirlas en clases mediante un umbral.
¿Qué hace la función sigmoide?
Transforma cualquier valor real en una probabilidad entre cero y uno.
¿Qué significa un coeficiente?
Representa un cambio en log-odds por unidad, manteniendo otras variables constantes; exp(coeficiente) da una razón de odds.
¿Debo usar umbral 0.5?
No. El umbral debe responder a costos, capacidad operativa y métricas evaluadas en validación.
¿Necesita variables normales?
No. Sí requiere una especificación razonable, independencia o dependencia tratada y relación adecuada con log-odds.
¿Cómo manejo clases desbalanceadas?
Usa métricas apropiadas, pesos o muestreo dentro del entrenamiento y ajusta el umbral con validación.
Deja una respuesta