
Parquet vs CSV: formato, tamaño y rendimiento
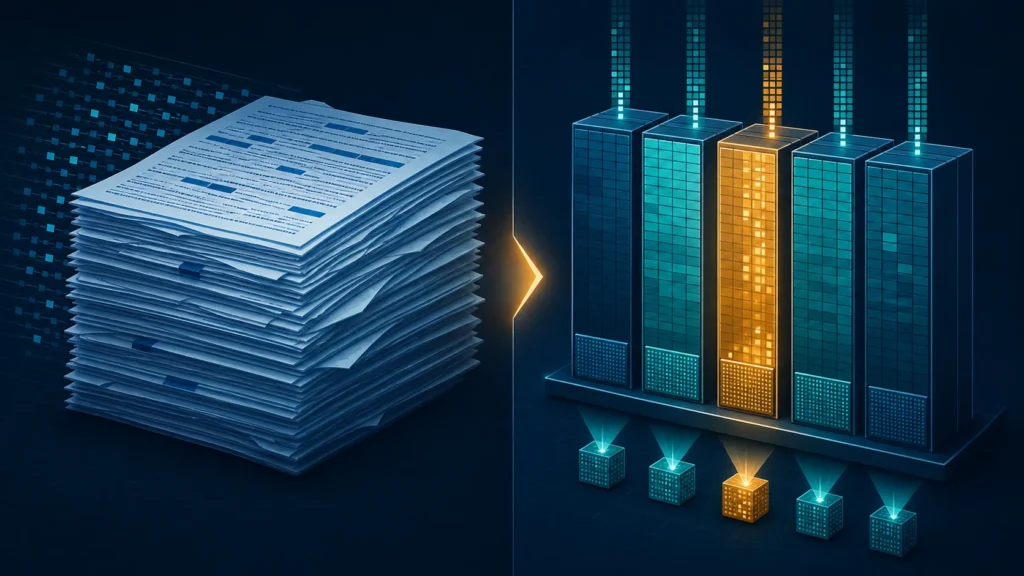
La comparación Parquet vs CSV enfrenta dos formatos con objetivos diferentes. CSV es texto tabular sencillo, ampliamente compatible y fácil de inspeccionar. Apache Parquet es un formato binario columnar diseñado para almacenar y consultar datos analíticos con tipos, compresión y lectura selectiva.
Cómo organiza los datos cada formato
CSV guarda una fila detrás de otra y separa campos mediante delimitadores. No incluye un esquema estándar completo: lector y escritor deben acordar codificación, separador, comillas, fechas, nulos y tipos.
Parquet organiza valores por columnas dentro de grupos de filas. Incluye metadatos y tipos, y permite que un motor lea solo las columnas necesarias. Esta disposición favorece consultas que analizan pocas variables de tablas anchas.
Tamaño y compresión
El texto repite representaciones y nombres de valores. Parquet agrupa datos similares y aplica codificaciones y compresión por columna, por lo que suele ocupar menos en datasets analíticos. El resultado exacto depende de cardinalidad, orden, codec y tamaño de grupos.
Un CSV también puede comprimirse con gzip, pero para consultar una parte generalmente hay que descomprimir y recorrer el flujo. Parquet permite saltar bloques mediante metadatos cuando los filtros y el motor lo soportan.
Rendimiento de lectura
Si una consulta necesita tres columnas de una tabla con cien, Parquet puede evitar leer las otras 97. Las estadísticas de grupos de filas permiten predicate pushdown: descartar bloques que no contienen valores compatibles con el filtro.
Para un archivo minúsculo abierto manualmente, CSV puede ser más rápido de manejar. En un lago de datos, miles de CSV pequeños elevan listados, apertura y análisis. Compactar archivos y dimensionar particiones suele importar tanto como el formato.
Tipos y calidad
CSV no distingue de forma intrínseca entre 00123, una fecha y una cadena; una hoja de cálculo incluso puede reinterpretarlos al abrir. Parquet conserva tipos como enteros, decimales, booleanos y marcas temporales, aunque distintas herramientas aún deben acordar zonas horarias y tipos lógicos.
El esquema no garantiza datos correctos. Valida rangos, nulabilidad, claves y evolución.
Escritura y actualización
Parquet es excelente para escribir lotes y leer analítica; no está pensado para modificar una fila individual en el archivo. Las plataformas suelen reemplazar particiones o crear nuevos archivos. Formatos de tabla como Delta Lake, Iceberg o Hudi añaden metadatos y transacciones sobre archivos columnares.
CSV es fácil de generar como exportación, pero tampoco ofrece transacciones ni concurrencia por sí mismo.
Interoperabilidad
CSV funciona prácticamente en cualquier lenguaje, editor y sistema, lo que lo hace útil para intercambios pequeños y requisitos humanos. Su simplicidad aparente exige un contrato: UTF-8, delimitador, escape, formato de fecha y representación de NULL.
Parquet está soportado por pandas, Spark, motores SQL y servicios cloud modernos, pero no se inspecciona correctamente en un editor de texto. Necesita una biblioteca compatible.
Particionamiento
Organizar carpetas por fecha, región u otra columna ayuda a descartar archivos completos. No uses columnas de cardinalidad extrema como customer_id si crearán millones de directorios. Elige filtros comunes y evita particiones demasiado pequeñas.
Parquet también contiene grupos de filas y páginas internas. Un archivo enorme puede limitar paralelismo; muchos archivos minúsculos generan sobrecarga. Mide en tu motor.
Evolución del esquema
Añadir una columna opcional suele ser manejable, pero cambiar tipos o renombrar requiere planificación. No dependas ciegamente de la inferencia. Mantén contratos, compatibilidad y pruebas entre productores y consumidores.
En CSV, un cambio de orden o delimitador puede romper lectores silenciosamente. Incluye cabeceras y versiona el contrato.
Cuándo elegir cada uno
Usa CSV para intercambio humano, exportaciones pequeñas, depuración y máxima compatibilidad. Elige Parquet para almacenamiento analítico, grandes volúmenes, consultas selectivas y pipelines donde importan tipos y coste de lectura.
En muchos sistemas ambos conviven: Parquet como formato interno y CSV como exportación controlada.
Prueba comparativa
No prometas un porcentaje universal. Crea una muestra representativa, escribe ambos formatos con configuraciones documentadas y mide tamaño, tiempo, memoria y bytes escaneados en consultas reales. Incluye lecturas completas, selección de columnas y filtros.
La decisión profesional considera herramientas consumidoras, frecuencia de escritura, esquema, tamaño de archivo, coste de almacenamiento, facilidad operativa y recuperación ante errores.
Continúa aprendiendo
Amplía este tema con nuestras guías sobre pandas concat, data lakehouse, Apache Spark.
Fuentes oficiales
Preguntas frecuentes
¿Qué diferencia principal hay entre Parquet y CSV?
Parquet es binario y columnar con tipos; CSV es texto fila a fila y depende de convenciones externas.
¿Parquet ocupa siempre menos?
Suele comprimir mejor datos analíticos, pero el resultado depende de cardinalidad, codec, orden y configuración.
¿Por qué Parquet puede leer más rápido?
Porque permite seleccionar columnas y descartar grupos de filas mediante metadatos y estadísticas.
¿Cuándo conviene CSV?
En intercambios pequeños, inspección humana y escenarios que requieren compatibilidad casi universal.
¿Parquet permite actualizar una fila?
El archivo no está diseñado para actualizaciones individuales; normalmente se reescriben archivos o particiones mediante una capa de tabla.
¿Cómo debo comparar formatos?
Con datos y consultas representativos, midiendo tamaño, tiempo, memoria y bytes escaneados en tu motor.
Deja una respuesta