
Orquestación de datos: pipelines confiables
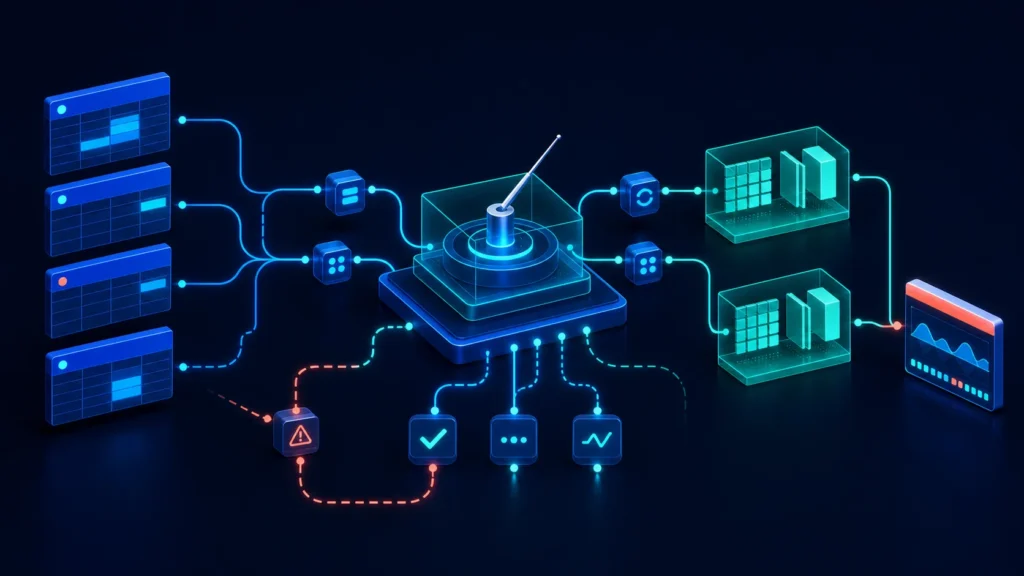
La orquestación de datos coordina tareas, dependencias, horarios, reintentos y alertas para que un pipeline se ejecute de forma predecible. No transforma necesariamente los datos: decide qué debe correr, cuándo, con qué parámetros y qué hacer ante un fallo.
Un script programado puede bastar para una tarea aislada. Cuando existen decenas de fuentes y consumidores, la orquestación convierte una colección de scripts en un sistema operable.
DAG: grafo de dependencias
Muchos orquestadores representan el flujo como un DAG, un grafo dirigido sin ciclos:
extraer_clientes ─┐
                  ├→ validar → construir_modelo → publicar
extraer_ventas  ──┘
Las dos extracciones pueden ejecutarse en paralelo. Validar espera a ambas. Publicar solo comienza si el modelo cumple sus controles.
Responsabilidades del orquestador
- programar ejecuciones;
- resolver dependencias;
- pasar parámetros;
- controlar concurrencia;
- reintentar fallos transitorios;
- registrar estados;
- emitir alertas;
- permitir backfills;
- administrar límites de tiempo;
- coordinar entornos.
La lógica de negocio debe permanecer en componentes probables y reutilizables. Un DAG con miles de líneas de transformación incrustada es difícil de probar fuera del orquestador.
Programación por tiempo o por evento
Un flujo por tiempo inicia a una hora o intervalo. Es simple, pero puede comenzar antes de que la fuente esté lista.
Un flujo por evento reacciona a una llegada, mensaje o actualización. Reduce espera, aunque requiere idempotencia, deduplicación y control de eventos tardíos.
También puede emplearse un sensor que verifica una condición. Evita sondeos agresivos y define timeout; esperar para siempre es un fallo no observado.
Reintentos
No todo error debe reintentarse:
- timeout de red: probablemente transitorio;
- credencial revocada: requiere intervención;
- esquema incompatible: reintentar no corrige;
- dato inválido: debe aislarse o bloquear según política.
Usa backoff, límite e información suficiente. Una tarea que escribe debe ser idempotente para que un reintento no duplique filas o envíe dos veces una notificación.
Backfill y reproceso
Un backfill ejecuta periodos históricos:
fecha_proceso = 2026-01-01 ... 2026-01-31
El pipeline debe recibir el periodo como parámetro, no depender solo de “hoy”. Separa fecha lógica de hora de ejecución. Controla concurrencia para no saturar la fuente y valida que el código actual pueda interpretar datos históricos.
La guía para construir pipelines amplía idempotencia, capas y pruebas.
Datos y metadatos de ejecución
Por cada tarea registra:
- identificador de corrida;
- periodo lógico;
- versión del código;
- entradas y salidas;
- filas leídas y escritas;
- inicio, fin y duración;
- estado;
- error;
- número de intento.
No guardes secretos ni datos personales completos en logs.
Controles de calidad
La calidad debe ser una dependencia, no un informe que nadie consulta:
cargar → validar esquema/volumen/unicidad → publicar
Define reglas bloqueantes y advertencias. Si una carga parcial no debe llegar al dashboard, publica solo después de pasar pruebas o intercambia tablas de forma atómica. Consulta calidad de datos.
SLA, SLO y frescura
No basta con “terminó”. Mide:
- hora límite de disponibilidad;
- duración;
- frescura del dato;
- tasa de éxito;
- tiempo de recuperación;
- retraso de dependencias;
- backlogs;
- costo por ejecución.
Una alerta accionable indica qué falló, desde cuándo, qué consumidor impacta y dónde revisar.
Orquestación y CDC
Los flujos continuos de Change Data Capture también necesitan coordinación: despliegues, checkpoints, reinicios, compactación y reconciliación. Orquestar no significa convertir todo en lotes.
Seguridad
- Usa identidades por tarea.
- Aplica mínimo privilegio.
- Almacena secretos en un gestor.
- Separa desarrollo y producción.
- Registra cambios de DAG.
- Requiere aprobación para acciones destructivas.
- Limita quién puede ejecutar backfills.
Errores frecuentes
- Depender de esperas fijas.
- Reintentar errores permanentes.
- No parametrizar el periodo.
- Mezclar orquestación y lógica.
- No controlar corridas simultáneas.
- Enviar alertas sin contexto.
- Marcar éxito antes de validar.
- No probar backfills.
- Crear una dependencia circular conceptual.
El mejor DAG cuenta una historia operativa clara: entradas disponibles, transformación reproducible, controles verificables y publicación explícita.
Preguntas frecuentes
¿Qué es la orquestación de datos?
Es la coordinación de tareas, dependencias, horarios, reintentos y estados de los pipelines.
¿Qué es un DAG?
Un grafo dirigido acíclico que representa tareas y dependencias sin ciclos.
¿Orquestar es lo mismo que transformar?
No. El orquestador coordina; las tareas ejecutan extracción, transformación, pruebas o publicación.
¿Cuándo debe reintentarse una tarea?
Ante fallos transitorios y solo si la operación es segura o idempotente, con límite y backoff.
¿Qué es un backfill?
Es el reproceso controlado de periodos históricos mediante parámetros de fecha lógica.
¿Cómo sé si un pipeline está sano?
Mide éxito, duración, frescura, calidad, retraso, costo y tiempo de recuperación, no solo estado final.
Deja una respuesta