
Apache Airflow: orquesta pipelines con DAG
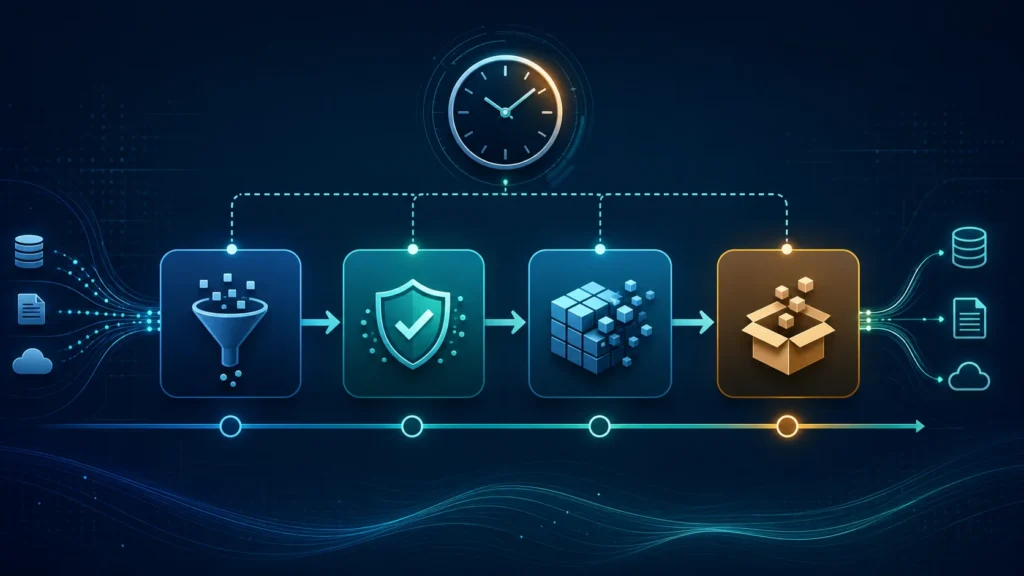
Apache Airflow es una plataforma para desarrollar, programar y monitorizar workflows por lotes. Un flujo se define como un DAG —grafo acíclico dirigido— formado por tareas y dependencias. Su principal fortaleza es convertir la orquestación en código versionable, observable y repetible.
Qué es un DAG
El grafo describe qué tareas existen y en qué orden pueden ejecutarse. Es acíclico porque ninguna cadena de dependencias puede regresar a su origen. Un pipeline típico extrae datos, valida, transforma, carga y publica métricas.
La definición debe ser rápida y, en lo posible, libre de efectos secundarios. Airflow analiza periódicamente los archivos de DAG; hacer consultas pesadas o llamadas externas durante la importación ralentiza el planificador.
Primer DAG conceptual
from datetime import datetime
from airflow.sdk import DAG, task

with DAG(
    dag_id="ventas_diarias",
    start_date=datetime(2026, 1, 1),
    schedule="@daily",
    catchup=False,
):
    @task
    def extraer():
        return "ruta_controlada"

    @task
    def transformar(ruta):
        return ruta

    transformar(extraer())
La API concreta depende de la versión instalada. Fija versiones de Airflow y proveedores, y consulta la documentación correspondiente al desplegar.
Scheduler, executor y workers
El scheduler decide qué instancias de tarea pueden ejecutarse. El executor determina cómo se lanzan y los workers realizan el trabajo en arquitecturas distribuidas. La base de metadatos guarda estados; el servidor web presenta la interfaz y los logs ayudan a diagnosticar.
Airflow no es el motor de transformación de grandes volúmenes. Debe orquestar trabajos en Spark, almacenes o contenedores, no mover gigabytes mediante mensajes internos.
Fechas lógicas y programación
Cada ejecución tiene un intervalo de datos y una fecha lógica. Un DAG diario suele ejecutarse después de que termine el intervalo que procesa. Comprender esta semántica evita el error de esperar que la fecha visible represente el instante real de inicio.
start_date debe ser fija y coherente. catchup controla si el scheduler crea intervalos históricos pendientes. Para backfills, prueba límites, capacidad y operaciones idempotentes antes de lanzar meses de datos.
Tareas idempotentes
Una tarea puede reintentarse, así que repetirla debería producir el mismo estado final. Escribe en particiones deterministas, usa claves de operación y evita insertar duplicados sin protección. No uses “ahora” para seleccionar datos si el intervalo lógico ofrece una referencia reproducible.
Separa archivos temporales por ejecución y publica resultados solo después de validarlos. Un retry no debe enviar dos veces una notificación comercial o cobrar de nuevo.
Dependencias y paso de datos
Las dependencias expresan orden, no transporte masivo. XCom sirve para metadatos pequeños, como un identificador o ruta, no para DataFrames grandes. Guarda datos en un almacenamiento adecuado y pasa una referencia.
Reduce cruces innecesarios: un DAG con cientos de tareas diminutas puede imponer más coste de orquestación que trabajo útil.
Sensores, datasets y ejecución por eventos
Un sensor espera una condición, por ejemplo la llegada de un archivo. Los modos diferibles liberan recursos mientras esperan. Los datasets o assets permiten programar flujos cuando se actualiza un conjunto de datos, según las capacidades de la versión.
Evita sensores que consultan cada pocos segundos y ocupan workers. Ajusta intervalos, timeouts y comportamiento ante ausencia.
Reintentos, alertas y SLA
Configura reintentos para fallos transitorios, con espera progresiva. Un error de esquema no se arreglará repitiendo cien veces. Distingue estados recuperables, añade timeout y envía alertas accionables con DAG, tarea, ejecución y enlace al log.
Monitoriza duración, colas, fallos, retraso de programación y frescura del dato. La interfaz es útil, pero métricas externas permiten detectar problemas antes que los usuarios.
Seguridad y secretos
Guarda credenciales en conexiones respaldadas por un gestor de secretos, no en el archivo del DAG. Limita permisos de workers y cuentas de servicio. Un DAG es código ejecutable: revisa contribuciones, controla dependencias y separa entornos.
Diseño mantenible
Mantén DAGs enfocados, tareas con entradas y salidas claras y nombres que describan el resultado. Prueba funciones puras fuera de Airflow, valida la carga del DAG en CI y simula una fecha concreta. Documenta propietario, fuente, destino, horario, dependencia y procedimiento de recuperación.
Airflow aporta control cuando el pipeline está diseñado para reintentos, backfills y observabilidad. Un DAG que solo encadena scripts frágiles seguirá siendo frágil, aunque aparezca en una interfaz elegante.
Continúa aprendiendo
Amplía este tema con nuestras guías sobre construcción de data pipelines, Apache Kafka, dbt para transformar datos.
Fuentes oficiales
Preguntas frecuentes
¿Qué es Apache Airflow?
Es una plataforma para definir, programar y monitorizar workflows por lotes mediante código.
¿Qué significa DAG?
Grafo acíclico dirigido: tareas conectadas por dependencias sin ciclos.
¿Airflow procesa los datos?
Orquesta tareas. Puede lanzar motores de procesamiento, pero no debería transportar grandes volúmenes como si fuera ese motor.
¿Qué es la fecha lógica?
La referencia al intervalo de datos que representa una ejecución, distinta del instante real en que comienza.
¿Para qué sirve XCom?
Para intercambiar metadatos pequeños entre tareas, no DataFrames ni archivos de gran tamaño.
¿Por qué deben ser idempotentes las tareas?
Porque pueden reintentarse o repetirse durante un backfill y deben evitar duplicados o efectos inconsistentes.
Deja una respuesta