
GROUP BY y HAVING en SQL: guía práctica
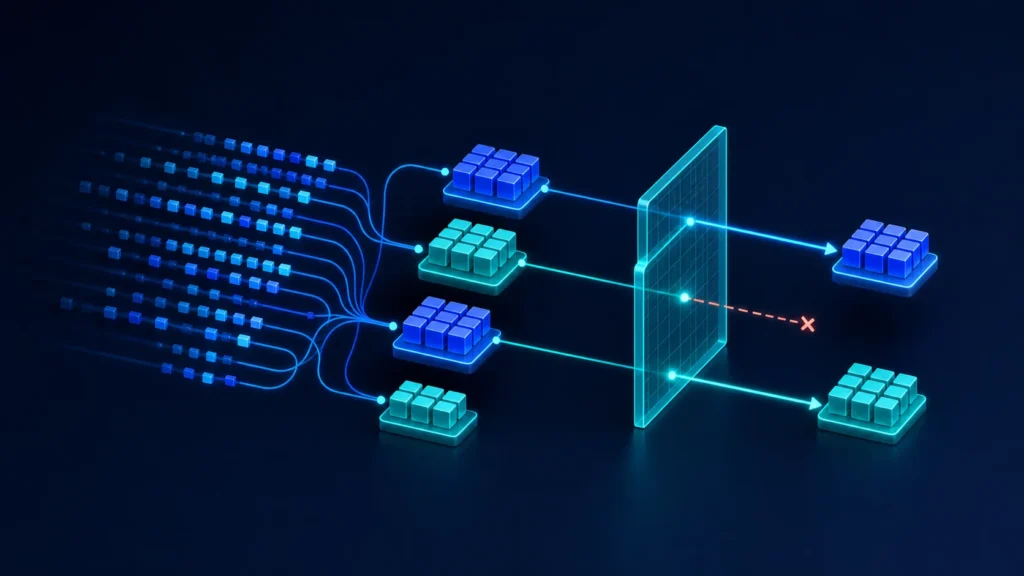
GROUP BY y HAVING permiten pasar de millones de registros detallados a resúmenes útiles. Con ellos puedes calcular ventas por región, clientes por mes o productos cuyo ingreso supera una meta. La clave está en distinguir filtrar filas de filtrar grupos.
Qué hace GROUP BY
GROUP BY reúne las filas que comparten valores y permite aplicar funciones agregadas como SUM, COUNT, AVG, MIN y MAX.
SELECT region,
       SUM(importe) AS ventas,
       COUNT(*) AS operaciones
FROM ventas
GROUP BY region;
La consulta devuelve una fila por región. Toda columna seleccionada que no esté dentro de una función agregada debe formar parte de la agrupación, salvo extensiones específicas del motor basadas en dependencias funcionales.
Agrupar por más de una columna
SELECT region,
       categoria,
       SUM(importe) AS ventas
FROM ventas
GROUP BY region, categoria;
La granularidad ahora es “una fila por región y categoría”. Añadir columnas a GROUP BY aumenta el detalle y normalmente el número de filas. Antes de escribir la consulta, completa esta frase: cada fila del resultado representa…
WHERE vs HAVING
WHERE filtra registros antes de agrupar; HAVING filtra los grupos después de calcular agregaciones:
SELECT cliente_id,
       SUM(importe) AS total
FROM ventas
WHERE fecha >= DATE '2026-01-01'
GROUP BY cliente_id
HAVING SUM(importe) >= 1000;
Primero se conservan ventas del periodo. Después se suman por cliente. Al final permanecen clientes con al menos 1.000 de ventas.
| Pregunta | Cláusula |
|---|---|
| ¿Qué filas entran al cálculo? | WHERE |
| ¿Qué grupos sobreviven al resumen? | HAVING |
| ¿Qué columnas definen cada grupo? | GROUP BY |
No muevas un filtro simple de filas a HAVING por comodidad. Filtrar pronto reduce el volumen y comunica mejor la intención.
COUNT: filas, valores y únicos
SELECT region,
       COUNT(*) AS filas,
       COUNT(email) AS emails_no_nulos,
       COUNT(DISTINCT cliente_id) AS clientes
FROM ventas
GROUP BY region;
COUNT(*) cuenta filas; COUNT(columna) ignora nulos; COUNT(DISTINCT columna) cuenta valores diferentes no nulos. Elegir uno u otro cambia la definición del indicador.
Agregación condicional
Puedes resumir varias condiciones en una sola pasada:
SELECT region,
       SUM(importe) AS ventas,
       SUM(CASE WHEN canal = 'web' THEN importe ELSE 0 END) AS ventas_web,
       COUNT(CASE WHEN estado = 'devuelto' THEN 1 END) AS devoluciones
FROM ventas
GROUP BY region;
El patrón combina GROUP BY con condiciones y evita múltiples subconsultas. Documenta qué ocurre con NULL y con categorías no contempladas.
Orden lógico de una consulta
Aunque se escribe SELECT primero, una forma útil de razonar es:
FROMyJOIN: construir el conjunto.WHERE: filtrar filas.GROUP BY: formar grupos.HAVING: filtrar grupos.SELECT: calcular y nombrar salidas.ORDER BY: ordenar el resultado.
Esto explica por qué normalmente no puedes usar en HAVING un alias creado en SELECT en todos los motores. Para cálculos complejos, crea primero una CTE y filtra su resultado.
Totales y porcentajes
Para calcular participación por región, combina la agregación con una función de ventana:
WITH resumen AS (
  SELECT region, SUM(importe) AS ventas
  FROM ventas
  GROUP BY region
)
SELECT region,
       ventas,
       100.0 * ventas / SUM(ventas) OVER () AS porcentaje
FROM resumen
ORDER BY ventas DESC;
La CTE produce una fila por región; la ventana calcula el total sin colapsar esas filas.
Errores comunes
- Seleccionar una columna que no pertenece a la agrupación.
- Confundir
COUNT(*)conCOUNT(columna). - Agrupar por demasiadas columnas y obtener casi el mismo detalle original.
- Usar HAVING para un filtro que debería ir en WHERE.
- Sumar importes después de un JOIN muchos a muchos.
- Redondear antes de agregar.
- Interpretar un promedio de promedios sin ponderar por tamaño.
Antes de aceptar el resultado, reconcilia el total con una consulta simple, inspecciona unos grupos manualmente y revisa duplicados en las claves de unión. La guía general de SQL puede servir como referencia para SELECT, filtros y ordenamiento.
Preguntas frecuentes
¿Cuál es la diferencia entre WHERE y HAVING?
WHERE elimina filas antes de agrupar. HAVING elimina grupos después de evaluar funciones agregadas como SUM o COUNT.
¿Puedo usar HAVING sin GROUP BY?
Algunos motores lo permiten y tratan todo el resultado como un solo grupo, pero suele ser más claro reservarlo para condiciones agregadas.
¿Por qué aparece un error al seleccionar una columna?
Porque una columna no agregada debe definir el grupo. Agrégala a GROUP BY o decide una agregación adecuada para ella.
¿COUNT cuenta valores nulos?
COUNT(*) cuenta filas, mientras COUNT(columna) ignora NULL. COUNT(DISTINCT columna) cuenta valores distintos no nulos.
¿Cómo agrupo por mes?
Convierte o trunca la fecha al mes con la función de tu motor y agrupa por esa misma expresión. Evita agrupar solo por el número de mes si existen varios años.
¿GROUP BY elimina duplicados?
Puede producir una fila por combinación agrupada, pero su propósito es resumir. Para deduplicar necesitas definir qué fila conservar y por qué.
Deja una respuesta