
Qué son los embeddings en inteligencia artificial
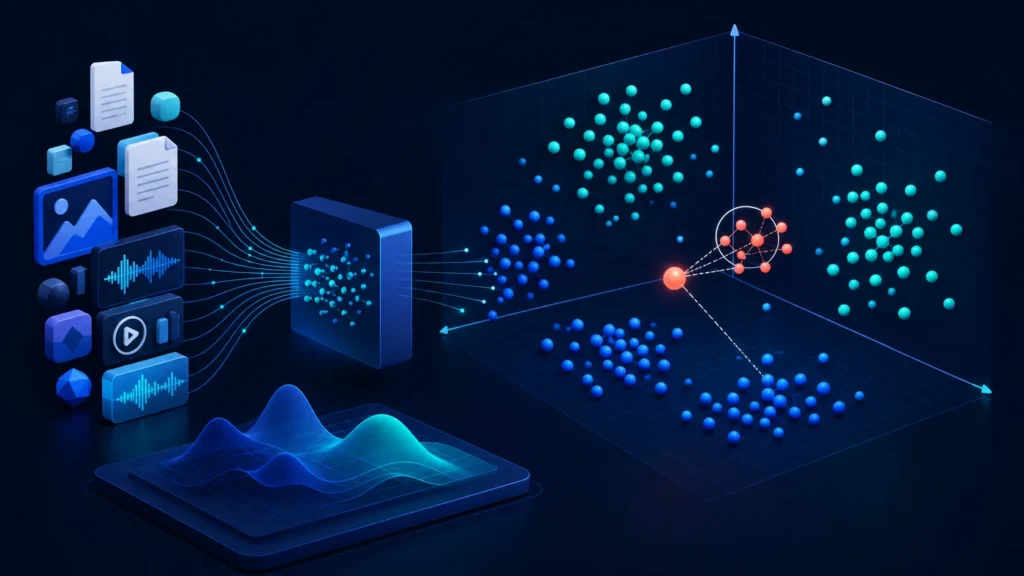
Los embeddings son representaciones numéricas densas de texto, imágenes, audio u otros objetos. Cada elemento se convierte en un vector; los objetos semánticamente parecidos tienden a quedar próximos en ese espacio.
Gracias a esa propiedad, una aplicación puede buscar documentos por significado, recomendar productos similares, agrupar contenidos y recuperar contexto para un sistema RAG.
Qué es un vector de embedding
Un vector es una lista ordenada de números:
[0.018, -0.442, 0.107, ...]
La dimensión depende del modelo. Cada número individual no suele tener una interpretación humana directa; el patrón completo codifica características útiles aprendidas durante el entrenamiento.
Dos frases como “cancelar mi suscripción” y “dar de baja el servicio” pueden quedar cerca aunque compartan pocas palabras.
Cómo se crean
Un modelo recibe el contenido y produce un vector:
contenido → modelo de embeddings → vector
Para texto, el modelo procesa tokens y genera una representación del fragmento. Para imágenes o audio, utiliza arquitecturas adaptadas a ese medio. Algunos modelos multimodales colocan diferentes formatos en un espacio compatible.
No calcules embeddings con modelos distintos y compares sus vectores como si pertenecieran al mismo espacio.
Similitud entre vectores
Similitud coseno
Mide el ángulo:
coseno(a, b) = (a · b) / (||a|| ||b||)
Un valor mayor suele indicar más similitud, según el modelo y la normalización.
Distancia euclidiana
Mide la distancia recta entre puntos. Puede ser adecuada si el modelo y el índice fueron diseñados para esa métrica.
Producto punto
Es rápido y frecuente en recuperación. Con vectores normalizados se relaciona estrechamente con coseno.
Usa la métrica recomendada por el modelo. No establezcas un umbral universal sin validar tu dominio.
Ejemplo de búsqueda semántica
- Divide el corpus en fragmentos.
- Genera un embedding para cada fragmento.
- Guarda vector, texto y metadatos.
- Genera el embedding de la consulta.
- Busca vecinos cercanos.
- Devuelve o reordena los candidatos.
Consulta: “¿Cómo puedo devolver un pedido?”
El sistema puede recuperar una política titulada “Reembolsos y cambios” aunque la palabra “devolver” no aparezca.
Embeddings vs búsqueda por palabras
| Enfoque | Fortalezas | Limitaciones |
|---|---|---|
| Palabras clave | Exactitud literal, códigos, nombres | No capta sinónimos bien |
| Embeddings | Significado y similitud | Puede fallar con detalles exactos |
| Híbrido | Combina ambos | Más complejidad |
Para catálogos y documentos empresariales, un enfoque híbrido suele equilibrar códigos exactos y lenguaje natural.
Bases de datos vectoriales
Un índice vectorial organiza embeddings para buscar vecinos aproximados sin comparar uno por uno. Puede ser:
- una extensión de una base relacional;
- un motor de búsqueda con vectores;
- una base vectorial dedicada;
- una biblioteca local.
Además del vector, guarda:
- identificador;
- contenido o referencia;
- fuente;
- fecha;
- idioma;
- permisos;
- versión;
- etiquetas.
Los metadatos permiten filtrar antes o durante la búsqueda.
Chunking y contexto
La unidad que conviertes en embedding importa:
- Documento completo: demasiados temas mezclados.
- Frase aislada: puede perder contexto.
- Sección coherente: suele equilibrar precisión y contexto.
Prueba tamaño, solapamiento y límites semánticos. Las tablas, preguntas frecuentes y código pueden requerir reglas específicas.
Casos de uso
Búsqueda semántica
Encuentra contenido por intención y significado.
Recomendaciones
Busca productos, artículos o usuarios cercanos en el espacio.
Clustering
Agrupa contenido sin etiquetas. Técnicas como K-means pueden operar sobre embeddings, aunque la alta dimensionalidad requiere evaluación.
Clasificación
Usa los vectores como características para un clasificador.
Detección de duplicados
Identifica textos casi equivalentes, no solo copias exactas.
RAG
Recupera fragmentos relevantes antes de generar una respuesta.
Ejemplo conceptual en Python
La API exacta depende del proveedor, pero el flujo es:
documentos = [
    "Política de devolución de productos",
    "Guía para restablecer la contraseña",
    "Condiciones de envío internacional",
]

vectores_documentos = modelo.embed(documentos)
vector_consulta = modelo.embed(["Cómo devolver una compra"])[0]

resultados = indice.buscar(
    vector=vector_consulta,
    top_k=5,
    filtros={"idioma": "es"},
)
Guarda la versión del modelo. Si cambias de modelo, normalmente debes volver a vectorizar el corpus.
Evaluar embeddings
No basta con mirar dos ejemplos. Crea un conjunto de consultas con resultados relevantes esperados y mide:
- recall@k;
- precision@k;
- mean reciprocal rank;
- nDCG;
- tasa de consultas sin resultado;
- latencia y costo;
- rendimiento por idioma, tema y longitud.
Revisa manualmente errores: términos ambiguos, negaciones, números, entidades y documentos parecidos con políticas diferentes.
Límites y riesgos
- La cercanía semántica no garantiza exactitud factual.
- Los vectores pueden codificar sesgos.
- Datos sensibles siguen siendo sensibles.
- Una actualización documental exige reindexación.
- El umbral cambia por dominio y modelo.
- Los embeddings pueden ser vulnerables a extracción o inferencias.
- La alta similitud no significa causalidad ni identidad.
- El contenido adversarial puede manipular recuperación.
Aplica permisos antes de devolver resultados, cifra almacenamiento y limita registros de consultas.
Embeddings vs one-hot
One-hot crea un vector disperso donde cada categoría ocupa una posición. No captura similitud por sí mismo. Un embedding es denso y aprendido: categorías relacionadas pueden quedar cercanas.
| Aspecto | One-hot | Embedding |
|---|---|---|
| Dimensión | Número de categorías | Fija por modelo |
| Densidad | Disperso | Denso |
| Similitud semántica | No implícita | Sí |
| Interpretación | Directa | Distribuida |
Buenas prácticas
- Define qué significa “relevante”.
- Usa un modelo apropiado para idioma y dominio.
- Normaliza según la métrica.
- Guarda modelo y versión.
- Incluye metadatos y permisos.
- Evalúa con consultas reales.
- Combina búsqueda léxica cuando existan códigos.
- Reindexa de forma controlada.
- Monitorea deriva y contenido obsoleto.
- No uses similitud como prueba factual.
Preguntas frecuentes
¿Qué es un embedding en palabras simples?
Es una lista de números que representa características aprendidas de un contenido para comparar similitud.
¿Para qué sirven los embeddings?
Para búsqueda semántica, recomendaciones, clustering, clasificación, deduplicación y recuperación para RAG.
¿Qué significa que dos vectores estén cerca?
Que el modelo considera similares sus representaciones según una métrica. No garantiza que ambos contenidos sean verdaderos o idénticos.
¿Qué es una base de datos vectorial?
Es un sistema que almacena vectores y permite buscar vecinos similares de forma eficiente.
¿Puedo comparar embeddings de modelos diferentes?
En general no. Cada modelo crea su propio espacio y dimensionalidad.
¿Los embeddings contienen el texto original?
No son una copia legible, pero pueden conservar información sensible y deben protegerse como datos derivados.
Deja una respuesta