
groupby en pandas: cómo agrupar y resumir datos
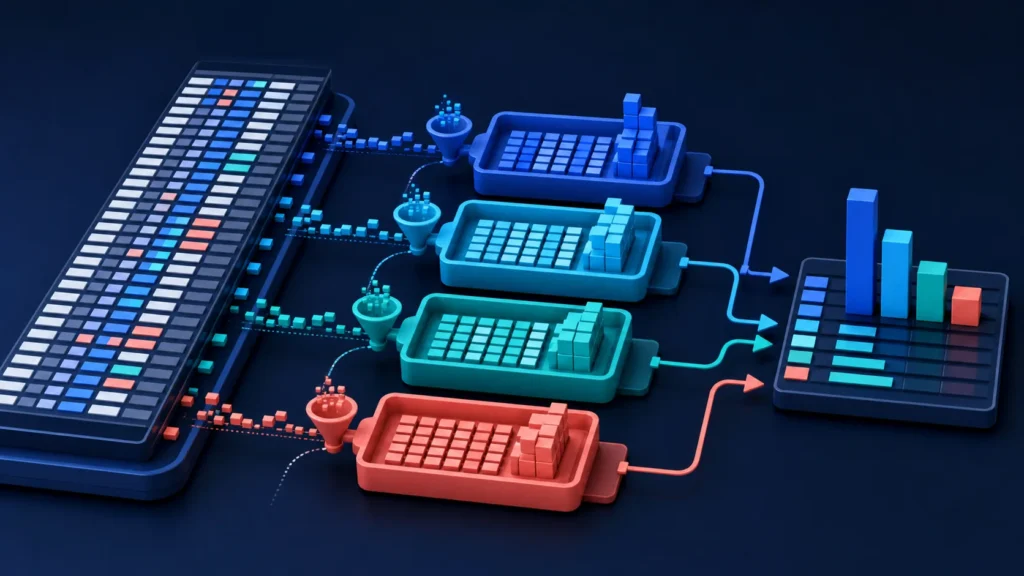
groupby en pandas permite dividir un DataFrame en grupos, aplicar cálculos y combinar los resultados. Es el equivalente programable de una tabla dinámica: calcula ventas por región, ticket medio por canal o número de clientes por mes sin escribir bucles.
La idea se conoce como split-apply-combine:
- separa filas por una o más claves;
- aplica una agregación, transformación o filtro;
- combina los resultados.
DataFrame de ejemplo
import pandas as pd

ventas = pd.DataFrame({
    "region": ["Norte", "Norte", "Sur", "Sur", "Sur"],
    "canal": ["Web", "Tienda", "Web", "Web", "Tienda"],
    "vendedor": ["Ana", "Luis", "Ana", "Marta", "Luis"],
    "importe": [1200, 800, 950, 1400, 700],
    "unidades": [4, 2, 3, 5, 2],
})
Agrupar por una columna
total_region = ventas.groupby("region")["importe"].sum()
print(total_region)
El resultado es una Series cuyo índice contiene las regiones. Si prefieres columnas normales:
total_region = (
    ventas
    .groupby("region", as_index=False)["importe"]
    .sum()
)
Varias agregaciones
resumen = (
    ventas
    .groupby("region")
    .agg(
        facturacion=("importe", "sum"),
        ticket_medio=("importe", "mean"),
        operaciones=("importe", "size"),
        unidades=("unidades", "sum"),
    )
    .reset_index()
)
Las agregaciones nombradas producen columnas claras y evitan un MultiIndex innecesario.
count vs size
sizecuenta filas, incluso si la columna elegida contiene nulos.countcuenta valores no nulos por columna.nuniquecuenta valores distintos no nulos por defecto.
Elige según la pregunta y documenta qué significa “operaciones”.
Agrupar por varias columnas
resumen = (
    ventas
    .groupby(["region", "canal"], as_index=False)
    .agg(
        facturacion=("importe", "sum"),
        operaciones=("importe", "size"),
    )
)
Cada combinación región-canal se convierte en un grupo.
transform: devolver un valor por fila
Una agregación reduce filas. transform devuelve una serie del mismo tamaño que el DataFrame original:
ventas["total_region"] = (
    ventas.groupby("region")["importe"].transform("sum")
)

ventas["porcentaje_region"] = (
    ventas["importe"] / ventas["total_region"]
)
Es ideal para porcentajes, medias de grupo e imputaciones sin hacer un merge.
ventas["importe_centrado"] = (
    ventas["importe"]
    - ventas.groupby("region")["importe"].transform("mean")
)
filter: conservar grupos completos
regiones_grandes = ventas.groupby("region").filter(
    lambda grupo: grupo["importe"].sum() >= 2500
)
filter evalúa cada grupo y conserva todas sus filas si cumple. Si solo necesitas el resumen, agrega y filtra después; suele ser más claro y eficiente.
apply: útil, pero no siempre necesario
resultado = ventas.groupby("region").apply(mi_funcion)
apply es flexible, pero una función Python personalizada puede ser más lenta y producir índices complejos. Antes de usarla, busca combinaciones de agg, transform, filter, rank, shift o ventanas nativas.
Agrupar fechas por mes
ventas["fecha"] = pd.to_datetime(ventas["fecha"])

mensual = (
    ventas
    .groupby(pd.Grouper(key="fecha", freq="MS"))
    .agg(facturacion=("importe", "sum"))
    .reset_index()
)
MS representa inicio de mes. También puedes crear una columna de periodo:
ventas["mes"] = ventas["fecha"].dt.to_period("M")
Valores nulos en las claves
Por defecto, groupby suele excluir grupos cuya clave es nula. Si quieres conservarlos:
ventas.groupby("region", dropna=False)["importe"].sum()
Decide si NaN significa “sin región”, “dato pendiente” o error. No lo rellenes con cero si cero tiene otro significado.
Categorías y observed
Con columnas categóricas, pandas puede mostrar combinaciones no observadas según la configuración y versión. Explicita el comportamiento:
ventas.groupby(
    ["region", "canal"],
    observed=True
)["importe"].sum()
observed=True devuelve combinaciones realmente presentes y suele ahorrar memoria.
Ranking dentro de cada grupo
ventas["ranking_region"] = (
    ventas
    .groupby("region")["importe"]
    .rank(method="dense", ascending=False)
)
Para comparar con la fila anterior:
ventas = ventas.sort_values(["vendedor", "fecha"])
ventas["importe_anterior"] = (
    ventas.groupby("vendedor")["importe"].shift(1)
)
groupby vs pivot_table
Ambos resumen datos, pero pivot_table crea una matriz de filas y columnas:
tabla = pd.pivot_table(
    ventas,
    index="region",
    columns="canal",
    values="importe",
    aggfunc="sum",
    fill_value=0,
    margins=True,
)
Usa groupby cuando el resultado seguirá dentro de un pipeline, tendrá varias transformaciones o necesita una forma tabular larga. Usa pivot_table cuando buscas una tabla cruzada lista para inspeccionar o exportar.
Encadenar un resumen reproducible
Un flujo profesional deja cada decisión visible:
resumen = (
    ventas
    .loc[lambda df: df["importe"].notna()]
    .assign(margen=lambda df: df["importe"] - df["costo"])
    .groupby(["region", "canal"], as_index=False, observed=True)
    .agg(
        facturacion=("importe", "sum"),
        margen=("margen", "sum"),
        pedidos=("pedido_id", "nunique"),
    )
    .assign(
        margen_pct=lambda df: df["margen"] / df["facturacion"]
    )
    .sort_values("facturacion", ascending=False)
)
El encadenamiento evita variables intermedias ambiguas y conserva el orden de limpieza, cálculo, agrupación y presentación.
Exportar el resumen sin perder estructura
Antes de guardar, ordena columnas, redondea solo para presentación y conserva los valores numéricos:
salida = resumen[
    ["region", "canal", "pedidos", "facturacion", "margen_pct"]
].copy()

salida.to_csv("resumen_ventas.csv", index=False)
No conviertas porcentajes a texto si el archivo continuará en un análisis. Aplica formato visual en la herramienta de destino y mantén una prueba con totales de control.
Rendimiento
- Selecciona columnas antes de agrupar.
- Usa agregaciones integradas en lugar de
apply. - Convierte claves repetidas a
categorycuando tenga sentido. - Usa
sort=Falsesi no necesitas ordenar grupos. - Evita lambdas que repiten cálculos.
- Lee datos con tipos correctos.
- Para archivos enormes, procesa por lotes o usa un motor distribuido.
groupby no corrige datos sucios. Revisa tipos, duplicados y nulos con una estrategia de limpieza de datos.
Errores comunes
- Confundir
countconsize. - Perder columnas porque se convierten en índice.
- Agrupar números almacenados como texto.
- Ignorar claves nulas.
- Usar
applypara una suma simple. - Agregar antes de eliminar duplicados legítimos o accidentales.
- Interpretar una media sin revisar tamaño y dispersión.
- Ordenar visualmente y asumir que el orden está garantizado.
Preguntas frecuentes
¿Qué devuelve groupby en pandas?
Primero devuelve un objeto GroupBy diferido. El resultado aparece al aplicar una agregación, transformación o filtro.
¿Cómo agrupo por dos columnas?
Pasa una lista: df.groupby(["region", "canal"]).
¿Qué diferencia hay entre agg y transform?
agg reduce cada grupo; transform devuelve un valor alineado con cada fila original.
¿Para qué sirve reset_index?
Convierte las claves agrupadas que quedaron como índice en columnas normales.
¿Cómo cuento filas por grupo?
Usa .size(); para contar valores no nulos de una columna, .count().
¿Por qué groupby omite los nulos?
Las claves nulas se excluyen por defecto en muchos casos. Usa dropna=False si deben formar un grupo.
Deja una respuesta