
Random Forest: qué es, cómo funciona y ejemplo en Python
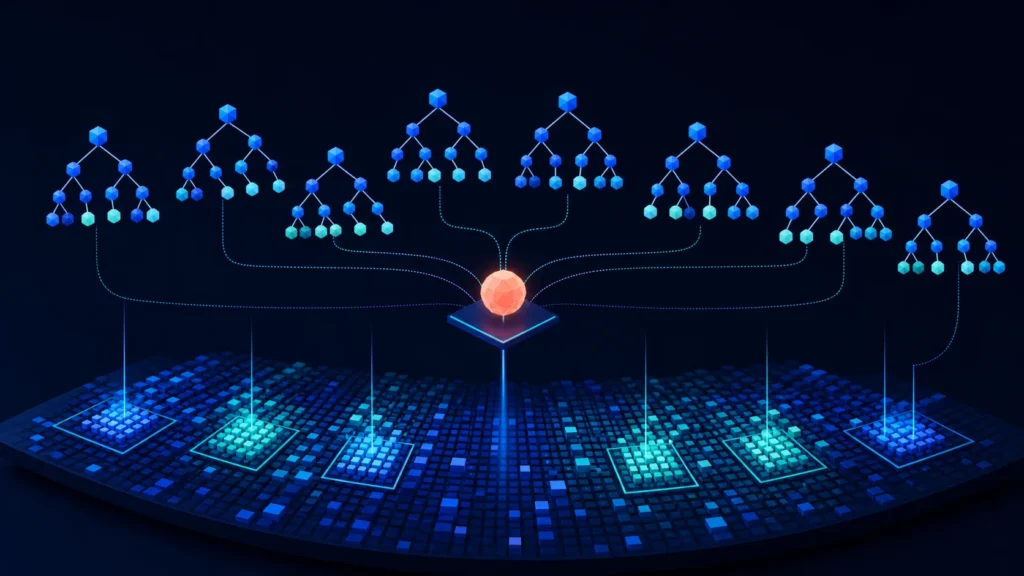
Random Forest, o bosque aleatorio, es un algoritmo que combina muchos árboles de decisión para producir una predicción más estable. Cada árbol aprende de una muestra y un subconjunto de variables ligeramente distintos; al final, el bosque vota en clasificación o promedia en regresión.
La idea es simple: un árbol individual puede memorizar el ruido, pero muchos árboles diversos tienden a compensar sus errores. Por eso Random Forest suele ofrecer un buen rendimiento con poca preparación y funciona como baseline sólido para datos tabulares.
Qué es Random Forest
Random Forest es un método de ensamble por bagging. Construye árboles en paralelo y agrega sus resultados.
- En clasificación, cada árbol predice una clase y gana la mayoría o se promedian probabilidades.
- En regresión, se promedian valores numéricos.
Es una extensión natural del árbol de decisión, pero reduce su alta varianza. Si necesitas el contexto previo, revisa la guía de machine learning para principiantes.
Cómo funciona paso a paso
1. Muestras bootstrap
Para cada árbol se selecciona una muestra del conjunto de entrenamiento con reemplazo. Algunas filas aparecen varias veces y otras quedan fuera.
2. Subconjuntos aleatorios de variables
En cada división, el árbol evalúa solo una selección aleatoria de atributos. Así evita que una variable dominante produzca árboles casi idénticos.
3. Árboles profundos y diversos
Cada árbol crece de manera independiente. Sus errores no son exactamente los mismos porque vio filas y variables distintas.
4. Agregación
El bosque combina todas las predicciones. La diversidad es crucial: promediar copias iguales no reduce el error.
Ejemplo intuitivo
Quieres predecir si un cliente cancelará una suscripción. Un árbol puede enfocarse en antigüedad y uso; otro, en incidencias y plan; otro, en pagos. Ninguno es perfecto, pero si una mayoría independiente detecta riesgo, la predicción agregada suele ser más robusta.
El modelo también captura interacciones y relaciones no lineales sin que tengas que escribirlas manualmente.
Ventajas y desventajas
| Ventajas | Limitaciones |
|---|---|
| Buen rendimiento inicial | Menos interpretable que un solo árbol |
| Captura no linealidades | Modelo más pesado |
| Tolera escalas distintas | Predicción más lenta con muchos árboles |
| Poco preprocesamiento | No extrapola bien fuera del rango |
| Sirve para clasificación y regresión | Importancia por impureza puede sesgar |
Normalizar no suele ser necesario porque los árboles comparan umbrales dentro de cada variable. Sí debes tratar valores faltantes según la implementación y convertir categorías de forma coherente.
Hiperparámetros importantes
n_estimators: número de árboles. Más árboles estabilizan, pero consumen tiempo.max_depth: profundidad máxima. Limitarla regulariza.min_samples_leaf: mínimo de filas en una hoja; valores mayores suavizan el modelo.max_features: variables candidatas por división; controla diversidad.class_weight: ayuda con clases desbalanceadas.max_samples: proporción usada en cada bootstrap.random_state: fija la aleatoriedad para reproducir resultados.
No optimices decenas de combinaciones contra el conjunto de prueba. Ajusta con validación cruzada y toca la prueba una sola vez al final.
Random Forest en Python
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import RandomForestClassifier
from sklearn.impute import SimpleImputer
from sklearn.metrics import classification_report, roc_auc_score
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder

X = clientes.drop(columns="cancela")
y = clientes["cancela"]

numericas = ["antiguedad", "sesiones", "tickets"]
categoricas = ["plan", "canal"]

preproceso = ColumnTransformer([
    ("num", SimpleImputer(strategy="median"), numericas),
    ("cat", Pipeline([
        ("imputer", SimpleImputer(strategy="most_frequent")),
        ("onehot", OneHotEncoder(handle_unknown="ignore")),
    ]), categoricas),
])

modelo = Pipeline([
    ("preproceso", preproceso),
    ("forest", RandomForestClassifier(
        n_estimators=500,
        min_samples_leaf=3,
        class_weight="balanced",
        random_state=42,
        n_jobs=-1,
    )),
])

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

modelo.fit(X_train, y_train)
pred = modelo.predict(X_test)
prob = modelo.predict_proba(X_test)[:, 1]

print(classification_report(y_test, pred))
print("ROC AUC:", roc_auc_score(y_test, prob))
El pipeline evita fuga de información: aprende imputaciones y categorías solo con entrenamiento.
Cómo evaluar el modelo
En clasificación, no uses solo exactitud. Si el 98 % de clientes no cancela, predecir siempre “no” logra 98 % sin aportar valor.
Revisa:
- precisión;
- recall;
- F1;
- matriz de confusión;
- ROC AUC;
- curva precision-recall;
- calibración si usarás probabilidades.
La matriz de confusión muestra qué tipo de error comete el bosque. Compleméntala con la guía de curva ROC y AUC y elige el umbral según el costo de falsos positivos y falsos negativos.
Cómo interpretar un Random Forest
Importancia por impureza
Es rápida, pero puede favorecer variables continuas o con muchas categorías. Úsala como exploración, no como explicación causal.
Importancia por permutación
Desordena una variable y mide cuánto empeora el modelo. Refleja mejor la contribución predictiva en un conjunto de validación.
from sklearn.inspection import permutation_importance

resultado = permutation_importance(
    modelo, X_test, y_test, n_repeats=10, random_state=42, n_jobs=-1
)
También puedes usar PDP o SHAP con cautela. Si dos variables están muy correlacionadas, la importancia puede repartirse o parecer menor de lo esperado.
Random Forest vs árbol de decisión
| Criterio | Árbol | Random Forest |
|---|---|---|
| Interpretación | Alta | Media-baja |
| Riesgo de sobreajuste | Alto | Menor |
| Entrenamiento | Muy rápido | Más costoso |
| Predicción | Una ruta | Agregación de árboles |
| Estabilidad | Cambia con los datos | Más robusto |
Si necesitas reglas que una persona pueda seguir, un árbol podado puede ser mejor. Si priorizas precisión estable en datos tabulares, el bosque suele ganar.
Errores comunes
- Evaluar antes de separar entrenamiento y prueba.
- Ajustar el umbral sin considerar el costo real.
- Ignorar desbalance de clases.
- Tratar la importancia de variables como causalidad.
- Introducir IDs o variables posteriores al resultado.
- Afinar demasiados parámetros y sobreajustar la validación.
- No comparar con un modelo simple.
Preguntas frecuentes
¿Random Forest sirve para clasificación y regresión?
Sí. Usa votación o probabilidades en clasificación y promedio de predicciones en regresión.
¿Hay que normalizar los datos?
Generalmente no, porque los árboles usan cortes por variable. Otros pasos, como imputar faltantes y codificar categorías, sí pueden ser necesarios.
¿Cuántos árboles debe tener un Random Forest?
No hay un número universal. Aumenta n_estimators hasta que la validación se estabilice y el costo de cómputo deje de compensar.
¿Random Forest evita por completo el overfitting?
No. Lo reduce frente a un árbol profundo, pero puede sobreajustar con fuga de información, hojas muy pequeñas o ajuste excesivo.
¿Qué es el error out-of-bag?
Es una estimación usando, para cada fila, los árboles que no la incluyeron en su muestra bootstrap. Puede ofrecer validación interna, aunque no sustituye siempre un diseño de evaluación adecuado.
¿Random Forest explica causas?
No. Aprende patrones predictivos. Las importancias indican utilidad para predecir, no efectos causales.
Deja una respuesta