
K-means clustering: cómo funciona y ejemplo en Python
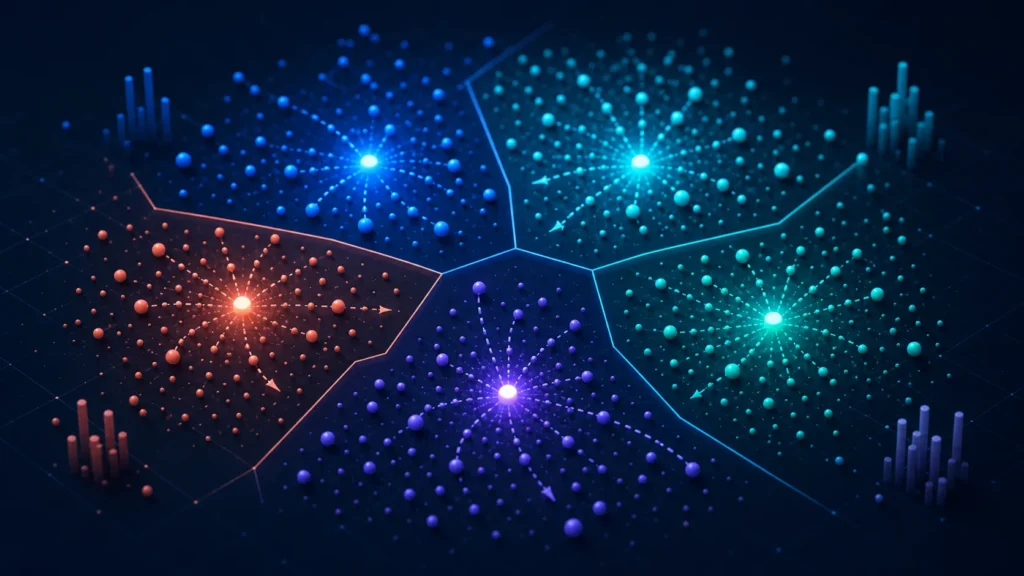
K-means es un algoritmo de aprendizaje no supervisado que agrupa observaciones parecidas en k clústeres. No necesita etiquetas previas: recibe variables numéricas, encuentra centros representativos y asigna cada punto al centro más cercano.
Se utiliza para segmentar clientes, comprimir imágenes, explorar patrones y crear variables para otros modelos. Su sencillez también exige cuidado: la escala, los valores atípicos y la elección de k pueden cambiar por completo el resultado.
Qué es K-means
El objetivo es minimizar la variación dentro de cada grupo. Formalmente, busca los centroides que reducen la suma de las distancias cuadráticas entre cada punto y el centro de su clúster.
Cada centroide es el promedio de las observaciones asignadas al grupo. No tiene que coincidir con un registro real.
K-means funciona mejor cuando:
- las variables son numéricas;
- los grupos son aproximadamente compactos y redondeados;
- los tamaños y densidades no son extremadamente distintos;
- la distancia euclidiana representa bien la similitud.
Cómo funciona el algoritmo K-means
1. Elige el número de clústeres
Debes indicar k antes de entrenar. Si eliges 4, el algoritmo siempre devolverá cuatro grupos, aunque la estructura natural sea otra.
2. Inicializa los centroides
Se seleccionan centros iniciales. La estrategia k-means++ los distribuye mejor que una elección totalmente aleatoria y suele acelerar la convergencia.
3. Asigna cada punto
Cada observación se asigna al centroide más cercano.
4. Recalcula los centros
Para cada grupo se calcula el promedio de sus puntos y el centroide se desplaza.
5. Repite
La asignación y el recálculo continúan hasta que los centroides casi no cambian o se alcanza el límite de iteraciones.
El algoritmo puede converger a una solución local distinta según el inicio. Por eso se ejecuta varias veces y se conserva el resultado con menor inercia.
Ejemplo: segmentación de clientes
Una tienda desea agrupar clientes usando:
- gasto anual;
- frecuencia de compra;
- antigüedad;
- descuento medio utilizado.
Los clústeres podrían revelar perfiles como compradores frecuentes, clientes de alto valor o usuarios sensibles a promociones. Esos nombres no los genera K-means: los asigna el analista después de estudiar las características de cada grupo.
No introduzcas identificadores, códigos postales sin tratar ni variables cuyo valor numérico no represente distancia. Un ID 900 no es “más” cliente que un ID 100.
La escala importa
Si el gasto va de 0 a 100,000 y la frecuencia de 1 a 20, la primera variable dominará la distancia. Estandariza:
z = (x − media) / desviación estándar
Así cada variable queda en una escala comparable. Para distribuciones con extremos fuertes puede convenir RobustScaler.
Cómo elegir k: codo y silhouette
Método del codo
Entrena varios valores de k y grafica la inercia. Esta siempre baja al aumentar los grupos; busca el punto donde la mejora adicional deja de ser grande. El “codo” no siempre es evidente.
Coeficiente silhouette
Compara la cohesión de cada punto con su grupo frente a la separación del grupo vecino. Toma valores entre −1 y 1:
- cerca de 1: punto bien asignado;
- cerca de 0: está en una frontera;
- negativo: podría pertenecer a otro grupo.
No elijas k solo por una métrica. Considera estabilidad, utilidad de negocio y si los segmentos pueden describirse y accionarse.
K-means en Python paso a paso
import pandas as pd
from sklearn.cluster import KMeans
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

clientes = pd.DataFrame({
    "gasto_anual": [1200, 1350, 9800, 10200, 4100, 4600, 900, 11000],
    "compras": [4, 5, 35, 38, 16, 18, 3, 40],
    "descuento": [0.30, 0.25, 0.05, 0.04, 0.15, 0.12, 0.35, 0.03],
})

modelo = make_pipeline(
    StandardScaler(),
    KMeans(n_clusters=3, n_init="auto", random_state=42),
)

clientes["cluster"] = modelo.fit_predict(clientes)

perfil = clientes.groupby("cluster").mean().round(2)
print(perfil)
El random_state hace reproducible la inicialización. El resumen por grupo permite interpretar el resultado.
Evaluar varios valores de k
from sklearn.metrics import silhouette_score
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

X = StandardScaler().fit_transform(clientes.drop(columns="cluster"))

for k in range(2, 7):
    modelo = KMeans(n_clusters=k, n_init="auto", random_state=42)
    etiquetas = modelo.fit_predict(X)
    score = silhouette_score(X, etiquetas)
    print(k, round(score, 3))
Después, visualiza los grupos con un gráfico de dispersión. Si hay más de dos variables, usa PCA solo para visualizar; el agrupamiento puede conservar el espacio original.
Limitaciones de K-means
- Necesita k por adelantado.
- Es sensible a la escala y a valores atípicos.
- Prefiere grupos compactos y aproximadamente esféricos.
- No trabaja directamente con categorías.
- Puede asignar un punto aunque esté lejos de todos los centros.
- Los clústeres no son verdades naturales: dependen de variables, transformación y objetivo.
Para formas irregulares o ruido, DBSCAN puede funcionar mejor. Para probabilidades de pertenencia, considera mezclas gaussianas. Con categorías, revisa k-modes o técnicas específicas.
Buenas prácticas
- Define para qué se usarán los segmentos.
- Limpia valores faltantes y extremos.
- Selecciona variables con significado.
- Estandariza dentro de un pipeline.
- Prueba varios
ky semillas. - Mide estabilidad en muestras diferentes.
- Describe los perfiles sin estereotipos.
- Recalibra si cambia la población.
K-means complementa la guía de machine learning para principiantes: aquí no existe una respuesta correcta conocida; la evaluación combina estructura estadística y utilidad.
Preguntas frecuentes
¿Qué significa la k en K-means?
Es el número de clústeres que el algoritmo debe construir. Se decide antes del entrenamiento.
¿K-means es supervisado o no supervisado?
Es no supervisado porque trabaja sin etiquetas objetivo y descubre agrupaciones basadas en distancia.
¿Por qué hay que normalizar los datos?
Porque la distancia euclidiana favorece variables con rangos grandes. Estandarizar evita que una escala domine a las demás.
¿Cómo sé cuántos clústeres usar?
Combina método del codo, silhouette, estabilidad y utilidad del resultado. No existe una regla universal.
¿K-means acepta variables categóricas?
No directamente. Codificarlas como números arbitrarios crea distancias sin sentido; usa un algoritmo apropiado o una representación justificada.
¿Qué diferencia hay entre K-means y KNN?
K-means agrupa datos sin etiquetas. KNN es un método supervisado que predice usando los vecinos etiquetados más cercanos.
Deja una respuesta